

你的電商平台顯示某位客戶上週買了三件產品,CRM 卻顯示他從未轉化,而廣告平台則說他的 ROAS 是零。三個系統,竟然有三個版本的「事實」——這正是讓行銷與 IT 團隊頭痛不已的「數據孤島 (Data Silo)」。要打破這個僵局,第一步就是明白 Data Ingestion 意思並建立自動化機制,將散落各處的資料集中起來。到底 Data Ingestion 是什麼,而數據攝取是如何運作?本文將為您一一解構。
數據攝取(Data Ingestion)是什麼?
在企業建構數據驅動決策的過程中,跨系統的資料傳輸往往是最大的瓶頸。了解數據攝取(Data Ingestion)的運作邏輯,不但能幫企業釐清數據流轉的起點,更能為後續的資料分析與商業應用打下堅實基礎。
技術層面的定義
數據攝取是什麼?簡單來說,Data Ingestion 的意思是把來自不同系統和格式的數據,穩定移動到一個集中儲存位置(例如數據倉庫、Data Lake 或 CDP)的完整過程。這個過程通常包含三個主要作:
- 擷取:從 CRM、電商、App 或廣告平台讀取原始資料。
- 傳輸:透過 API 或訊息佇列(Message Queue)安全搬移資料。
- 載入:順利寫入目標儲存庫。
而它與常聽到的 ETL 有何不同?簡單的分別就是數據攝取專注於「搬移與收集」數據,而 ETL 則是在搬移的過程中,另外加入了複雜的「資料轉換」步驟。
數據帝國的中央物流系統
把這個概念想像成零售商的物流中心會更容易理解。各大供應商每天出貨,但如果物流中心沒有統一的收貨、分類與入庫機制,最終只會換來一個誰也找不到東西的混亂倉庫。
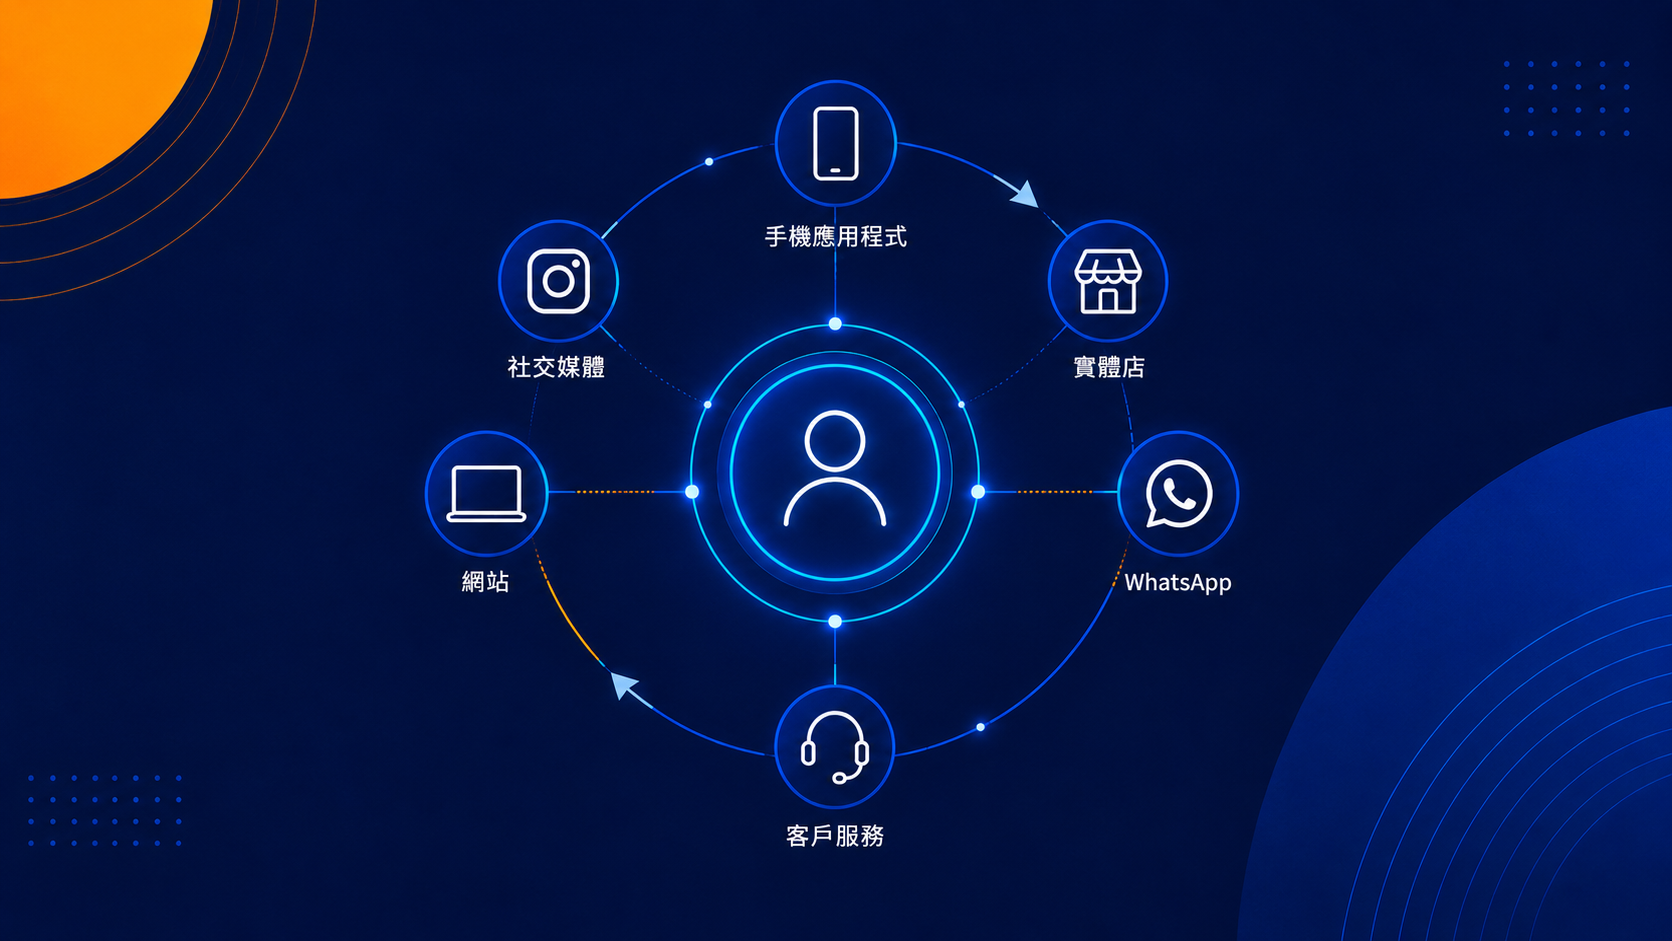
以一家同時經營網店、實體店和 WhatsApp 客服的香港品牌為例,他們每天會產生數萬個客戶互動事件。如果沒有建立順暢的流程,這些數據永遠只會被困在各自的系統裡無法產生價值。

為何數據攝取是企業數據戰略的基石?
數據不只是企業的資產,更是驅動商業成長的燃料;然而,若無法及時、精準且合規地將數據匯入核心系統,這些資產便無法發揮應有的價值。建立完善的攝取架構,正是將雜亂無章的原始資料轉化為高價值商業洞察的關鍵樞紐。
打破數據孤島
現代企業通常使用十個以上的平台管理客戶互動,而且每個系統都有自己的數據格式。在沒有結構化的流程下,分析師每星期只能手動導出 CSV 檔,再用 Excel 拼接,報告在還沒有完成前就已經過時。
賦能實時決策與個人化體驗
當用戶放棄購物車時,最有效的挽回時機是接下來的幾分鐘。透過實時串流技術,系統能在客戶行動的當下捕捉事件,並立刻觸發自動化挽回流程。麥肯錫數據顯示,能提供個人化體驗的企業,收入增長比同業快 40%,而個人化的重要前提,就是擁有即時可用的數據。
提升數據質量與管治能力
好的管道能同時把關數據品質:在數據進入核心儲存庫之前,就先執行格式驗證、去重與異常偵測。特別是對於需要符合香港《個人資料(私隱)條例》 (PDPO) 的企業,這一層更是建立稽核軌跡的最佳防線。
批次(Batch)vs. 實時(Real-time)
不同業務場景對數據的時效性需求大不相同,因此選擇合適的傳輸機制是建構數據管道時的重要考量。掌握批次與實時處理的差異,能幫助企業在技術成本、系統複雜度與商業效益之間取得最佳平衡。
批次數據攝取 (Batch)
以固定間隔(每小時、每日)搬移大量數據。技術相當成熟,且成本較低。
- 適用:財務月結、每日銷售匯入、歷史數據遷移。
- 優點:處理效率高、資源消耗可預測、易於監控。
- 缺點:存在延遲、不適合即時反應場景。
實時數據攝取(Real-time / Streaming)
持續且近乎零延遲地傳輸數據。常見技術包括 Apache Kafka、AWS Kinesis 及各大 CDP 的原生事件串流。
- 適用:用戶行為追蹤、即時詐騙偵測、購物車放棄觸發。
- 優點:數據即時可用、支援即時自動化。
- 缺點:架構複雜、運營成本較高。
企業該如何選擇?
大多數成熟的架構會同時使用兩者:利用實時串流捕捉當下的用戶行為事件,再用批次處理來定期整合交易數據。在執行前,您可以先問自己一個關鍵問題:「這份數據如果延遲一小時才拿到,會影響商業決策或客戶體驗嗎?」會影響,就用實時;不會影響,批次處理就已經足夠。
數據攝取的常見挑戰
- 數據來源多樣性(Data Variety):JSON、CSV、XML、Webhook 事件…格式不一是最常見的瓶頸,管道必須具備彈性架構來統一多種輸入格式。
- 數據量與擴展性(Data Volume):擁有百萬 MAU 的應用程式每天可產生數十億事件,架構需要在流量高峰時自動擴展,低峰時收縮資源以節省成本。
- 安全與合規(Security & Compliance):資料傳輸過程必須加密。香港受 PDPO 規範,這一步是執行用戶同意過濾、PII 去識別化和紀錄存取日誌的最佳執行點。
專為客戶數據攝取而設的解決方案
如果您想了解在實際應用中 Data Ingestion 是什麼樣貌,CDP(客戶數據平台)就是最具代表性的例子:
預建連接器簡化整合
以 Segment 為例,它提供超過 400 個預建連接器,涵蓋主流廣告平台、電商、CRM 和分析工具。工程師不需為每個資料源重新編寫定制管道,只要啟用連接器即可開始接收數據。mParticle 提供相似生態,並針對行動應用事件追蹤有更深優化,將原本需要數週的工程工時,壓縮到幾小時的配置。
同時靈活處理批次與實時數據流
Segment 的 Connections 能同時處理串流事件和批次文件;Amplitude 也允許工程師透過 HTTP API 即時推送事件,同時以 CSV 導入歷史數據,讓兩者完美匯入同一個用戶 Profile 中。
在攝取過程中執行驗證與清洗
Segment 的 Protocols 功能可預先定義事件的「標準合約」(如必填欄位、數據類型)。任何不符標準的異常事件會在最前端被攔截,而不是默默地污染整個數據庫,省去後續維護的龐大成本。
準備好為您的企業打造高效率的資料傳輸架構了嗎?
在這個數據驅動決策的時代,清楚瞭解數據攝取是什麼並掌握其運作邏輯,是企業打破資料孤島、釋放數據價值的關鍵第一步。理解 Data Ingestion 意思不但能幫助團隊梳理全渠道的客戶足跡,更能透過自動化的數據攝取管道,為後續的分析與個人化行銷奠定穩固基礎。若您想進一步釐清 Data Ingestion 是什麼,以及如何為品牌挑選最合適的 CDP 解決方案,歡迎立即聯繫 Master Concept 的資料顧問團隊,讓我們為您打造可擴展的數據架構,開創全新的業務增長點!
常見問題 FAQ
數據攝取 (Data Ingestion) 是什麼意思?
它是指把來自不同系統和格式的數據,移動到一個集中儲存位置(例如數據倉庫、Data Lake 或 CDP)的過程。它主要由「擷取資料、安全傳輸、載入儲存」三個主要動作組成,是企業打破數據孤島、建立 360 度統一客戶視圖最關鍵的基礎第一步。
Data Ingestion 和 ETL 有什麼分別?
兩者的核心差異在於「是否包含資料轉換」:Data Ingestion 專注於資料的搬移,而 ETL 則會在搬移途中進行轉換。實務上兩者常結合使用,先透過 Data Ingestion 把原始數據納入,再利用 ETL 加工成分析可用的格式。
批次攝取和實時攝取應該怎樣選?
選擇的關鍵標準在於「數據如果延遲一小時,是否會影響業務決策或客戶體驗」。會,就需要實時攝取(例如購物車放棄觸發、詐騙偵測)。不會,批次已經足夠(例如每日銷售匯總、財務月結)。大多數成熟的企業架構同時使用兩種方式。
為什麼企業需要 CDP 來處理數據攝取?
因為 CDP 能將原本需要數週的工程開發時間,大幅壓縮至數小時的系統配置。 CDP 提供預建連接器(如Segment 有超過 400 個),無需工程師手寫定制管道。CDP 亦能提供雙軌支援,同時彈性處理批次檔案與實時事件串流。另外,在入口處直接執行 Schema 驗證,能及時攔截不符合標準的異常事件,防止資料污染下游庫。
數據攝取如何符合香港的私隱法規?
這是建立合規控制點的最佳防線,能確保資料在寫入核心系統前就符合《個人資料(私隱)條例》(PDPO) 規範。企業可在傳輸入口處設置三道防線:自動執行用戶同意 (Consent) 過濾、完成 PII 個人敏感資料去識別化,以及記錄完整存取日誌,同時搭配 TLS/SSL 傳輸加密,即可有效降低合規風險。